Avevo delle GPU ferme, inutilizzate. In questo periodo stiamo organizzando i dati per un modello interno — un lavoro di curazione lento e attento, che non tiene occupato l’hardware. Così ho pensato: nel frattempo, facciamo un test.
Non un modello serio. Un esperimento. Volevo rispondere a una domanda che mi ponevo da tempo:
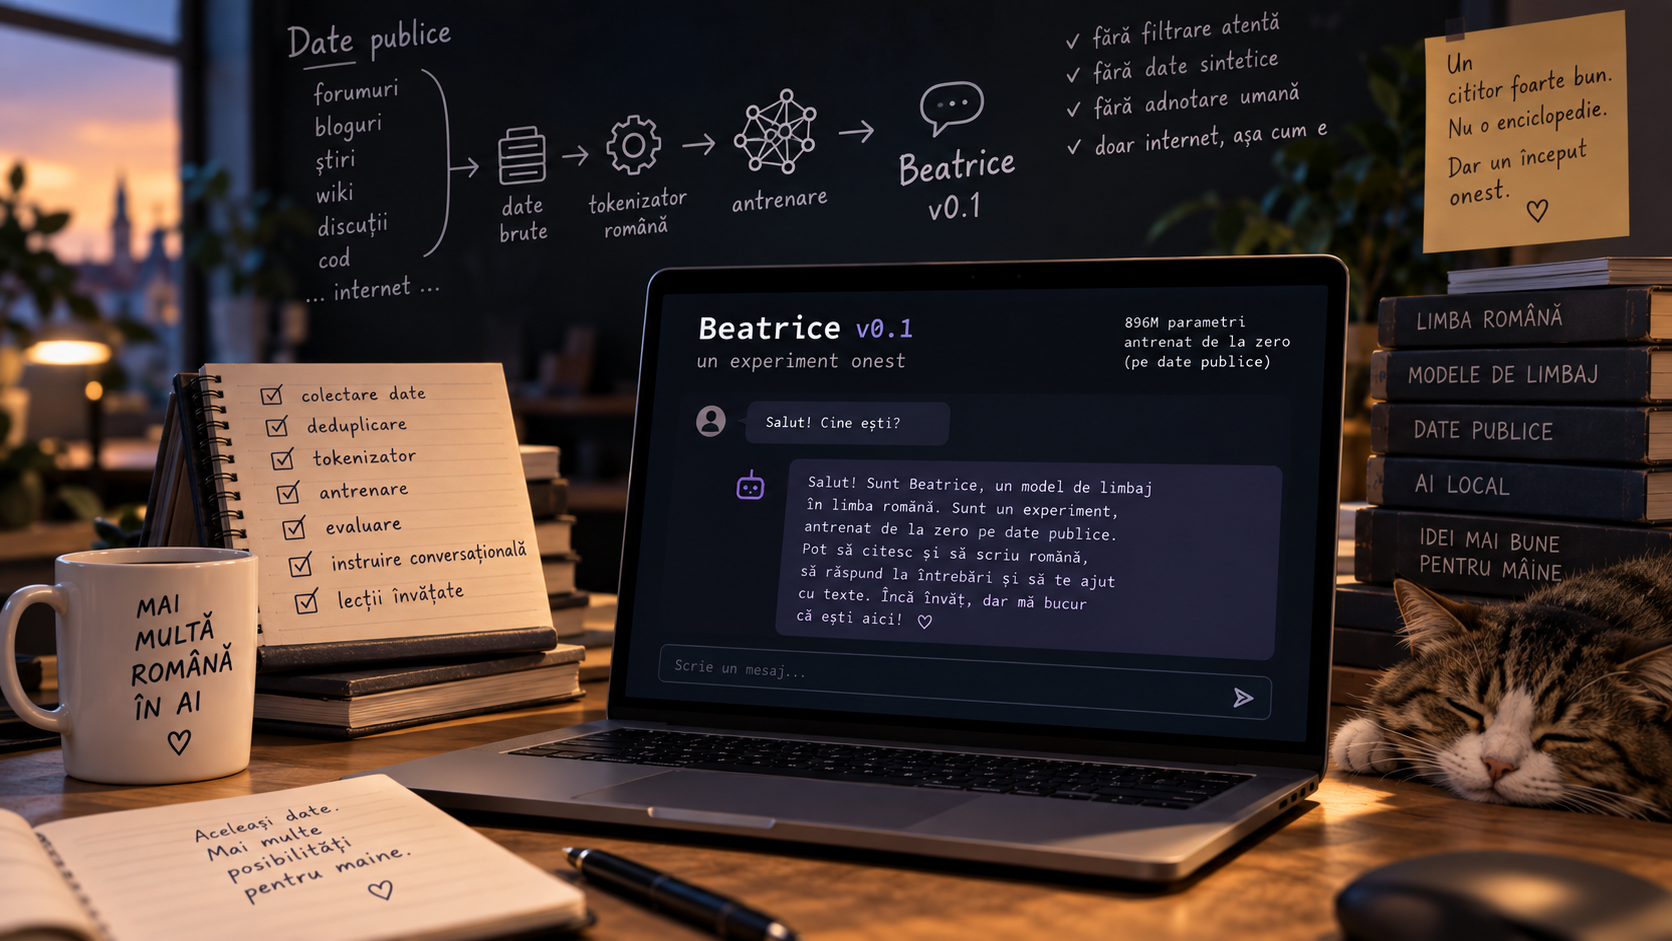
Cosa viene fuori se addestri un modello linguistico rumeno da zero, usando solo dati pubblici, raccolti da internet esattamente così come sono — senza un filtraggio accurato, senza curazione, senza dati sintetici, senza annotazione umana?
Il risultato si chiama Beatrice v0.1. Puoi provarlo subito.
Cos’è, in realtà
Un modello da 896 milioni di parametri, addestrato da zero, quasi interamente in rumeno (il resto un po’ di inglese e codice, per la struttura di ragionamento).
E, per essere chiari fin dall’inizio: Beatrice non pretende di essere intelligente. Non è un modello di produzione, non compete con niente. È un test del nostro processo di addestramento — il pipeline dai dati grezzi fino a un modello che parla. Volevo vederlo funzionare end-to-end prima di investire nel modello vero.
Ho costruito l’intera catena: filtraggio, deduplicazione, un tokenizzatore addestrato da zero sul rumeno (due volte più efficiente di quello di GPT-2 sul testo rumeno), la miscela di dati, l’addestramento, il fine-tuning conversazionale. Ogni pezzo ha funzionato. Questo era il vero obiettivo.
Cosa ho imparato, ed è la parte interessante
Ho valutato il modello su oltre mille domande. Ne è emerso un profilo che dice tutto su cosa sia un modello di queste dimensioni:
- Scrive un rumeno corretto e naturale. Grammatica, diacritici, ordine delle parole naturale, espressioni idiomatiche. Qui il corpus filtrato ha mostrato il suo valore.
- Eccelle nella comprensione del testo. Dagli un contesto e una domanda su di esso, ed estrae la risposta giusta. Nei miei test: 100%.
- Inventa i fatti. Interrogato “a memoria” su popolazioni, anni, nomi — risponde con sicurezza cose false. Sui quiz di conoscenza generale ottiene un punteggio casuale.
In altre parole: un ottimo lettore, non un’enciclopedia.
E questo non è un difetto da correggere — è il profilo di un modello da 896M di parametri. Non ha dove immagazzinare conoscenza sul mondo. Ciò che sa fare, e fa bene, è leggere un testo e riformularlo in rumeno pulito. Da qui la conclusione pratica: un modello piccolo come questo funziona meglio abbinato a una fonte di informazioni — gli dai il testo, lui fa la formulazione. Lasciato solo, allucina.
È una lezione che conoscevo in teoria. Ora ce l’ho misurata, in rumeno.
L’onestà conta più dell’hype
Avrei potuto scrivere “ho addestrato un LLM rumeno” e fermarmi lì. Ma Beatrice ha limiti reali, e li dichiaro tutti: inventa, non ammette quando non sa, non ha filtri di sicurezza. Li ho scritti anche nella model card, nero su bianco.
Non per modestia. Perché un modello presentato come più di quello che è invecchia male — le persone ne scoprono i limiti comunque, da sole. Meglio conoscerli dall’inizio e concentrarsi su ciò che fa davvero bene.
E ciò che Beatrice fa bene — leggere e scrivere in rumeno — non è poco per un esperimento uscito da GPU che altrimenti sarebbero rimaste ferme.
Cosa viene dopo
Beatrice v0.1 è il passo zero. Tra 1–2 mesi addestreremo il modello vero, su dati filtrati e di qualità — sintetici più scritti da persone, non testo pubblico grezzo. Sarà più coerente, meno incline ad allucinare, e probabilmente più facile da eseguire.
La differenza tra i due non sarà la dimensione del modello. Sarà la qualità dei dati. Beatrice ne è la prova, per controesempio: dati grezzi → un lettore competente ma che confabula. Voglio vedere quanto si alza l’asticella quando i dati sono organizzati con cura.
Provalo tu stesso
Il modello è pubblico. Chi è curioso può provarlo:
🔗 huggingface.co/krakiun/ro-nanochat-d20-chat
Gira in locale, con un solo comando — le istruzioni sono nella pagina del modello. Nessun account, nessun cloud, niente lascia il tuo computer.
Digli “ciao”, fagli una domanda, dagli un testo e chiedigli di rispondere basandosi su di esso. Vedrai presto sia cosa sa fare sia dove inciampa. Entrambi sono interessanti.
Feedback e critiche sono benvenuti. Beatrice non è stata costruita per impressionare — è stata costruita per imparare da lei. E la critica onesta ne fa parte.
 Di