Aveam niște plăci video care stăteau degeaba. În perioada asta organizăm datele pentru un model intern — muncă lentă, de curatare, care nu ține hardware-ul ocupat. Așa că mi-am zis: până una-alta, hai să facem un test.
Nu un model serios. Un experiment. Voiam să răspund la o întrebare pe care mi-o pun de mult:
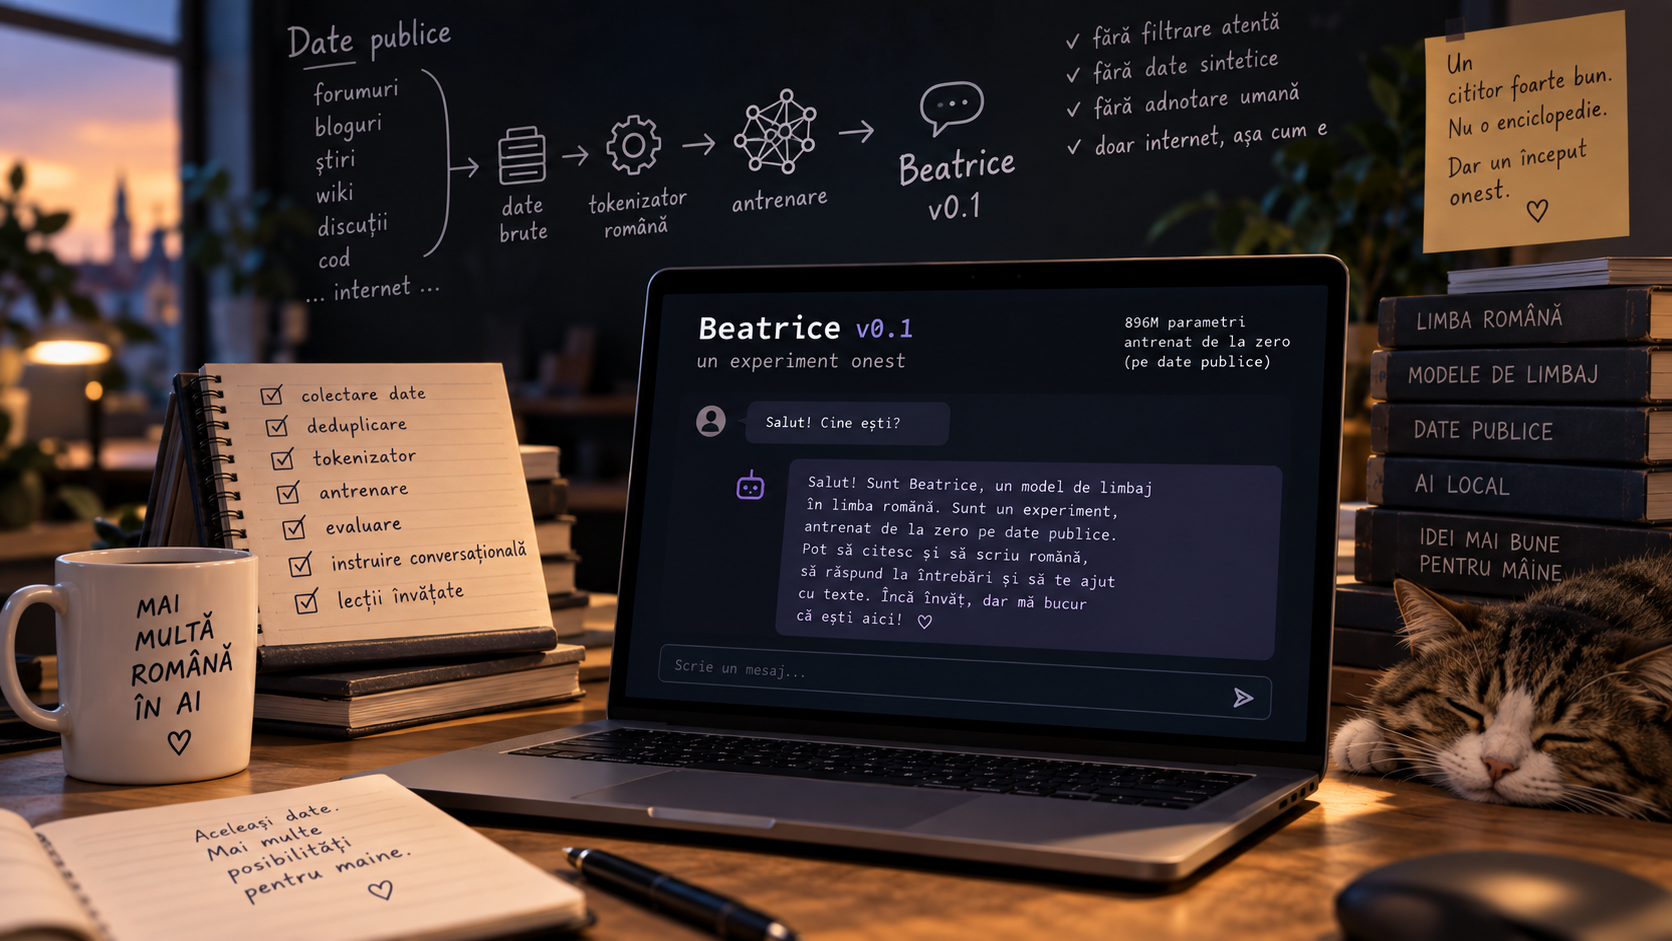
Ce iese dacă antrenezi un model de limbaj românesc de la zero, folosind numai date publice, colectate de pe internet exact așa cum sunt — fără filtrare atentă, fără curatare, fără date sintetice, fără adnotare umană?
Rezultatul se numește Beatrice v0.1. Îl poți testa chiar acum.
Ce este, de fapt
Un model de 896 de milioane de parametri, antrenat de la zero, aproape în întregime pe română (restul, puțină engleză și cod, pentru structură de raționament).
Și, ca să fie clar din prima: Beatrice nu-și propune să fie inteligentă. Nu e un model de producție, nu concurează cu nimic. E un test al procesului nostru de antrenare — pipeline-ul de la date brute până la un model care vorbește. Voiam să văd că funcționează cap-coadă, înainte să investim în modelul adevărat.
Am construit tot lanțul: filtrare, deduplicare, un tokenizator antrenat de la zero pe română (de două ori mai eficient decât cel al GPT-2 pe text românesc), amestecul de date, antrenarea, instruirea conversațională. Fiecare piesă a mers. Ăsta a fost scopul real.
Ce am învățat, și e partea interesantă
Am evaluat modelul pe peste o mie de întrebări. A ieșit un profil care spune tot despre ce înseamnă un model de dimensiunea asta:
- Scrie română corectă și naturală. Gramatică, diacritice, topică firească, expresii idiomatice. Aici corpusul filtrat și-a arătat valoarea.
- Excelează la înțelegerea de text. Dacă îi dai un context și o întrebare despre el, extrage răspunsul corect. În testele mele: 100%.
- Inventează fapte. Întrebată „din memorie" despre populații, ani, nume — răspunde cu încredere lucruri false. La grile de cunoștințe generale, nimerește la nivelul hazardului.
Cu alte cuvinte: un cititor foarte bun, nu o enciclopedie.
Și asta nu e un defect de reparat — este profilul unui model de 896M de parametri. Nu are unde să stocheze cunoștințe despre lume. Ce poate face, și face bine, e să citească un text și să-l reformuleze în română curată. De aici și concluzia practică: un model mic ca ăsta funcționează cel mai bine cuplat cu o sursă de informații — îi dai textul, el formulează. Lăsat singur, halucinează.
E o lecție pe care o știam în teorie. Acum o am măsurată, în română.
Onestitatea contează mai mult decât hype-ul
Aș fi putut scrie „am antrenat un LLM românesc" și să mă opresc acolo. Dar Beatrice are limite reale, și le spun pe toate: inventează, nu recunoaște când nu știe, nu are filtre de siguranță. Le-am scris și în model card, negru pe alb.
Nu din modestie. Ci pentru că un model prezentat drept mai mult decât e îmbătrânește prost — oamenii îi descoperă limitele oricum, singuri. Mai bine le știi de la început și te concentrezi pe ce chiar face bine.
Iar ce face Beatrice bine — să citească și să scrie română — nu e puțin lucru pentru un experiment ieșit din niște plăci care altfel ar fi stat degeaba.
Ce urmează
Beatrice v0.1 e pasul zero. Peste 1–2 luni antrenăm modelul adevărat, pe date filtrate și de calitate — sintetice plus scrise de oameni, nu text public brut. Va fi mai coerent, mai puțin predispus la halucinare, și probabil mai ușor de rulat.
Diferența dintre cele două nu va fi dimensiunea modelului. Va fi calitatea datelor. Beatrice e dovada, pe cale negativă: date brute → un cititor competent, dar care confabulează. Vreau să văd cât urcă ștacheta când datele sunt organizate cu grijă.
Testeaz-o singur
Modelul e public. Cine e curios îl poate încerca:
🔗 huggingface.co/krakiun/ro-nanochat-d20-chat
Rulează local, cu o singură comandă — instrucțiunile sunt în pagina modelului. Nu trebuie cont, nu trebuie cloud, nu pleacă nimic de pe calculatorul tău.
Spune-i „salut", pune-i o întrebare, dă-i un text și cere-i să răspundă pe baza lui. O să vezi repede și ce poate, și unde se împiedică. Ambele sunt interesante.
Feedback și critici, binevenite. Beatrice n-a fost făcută să impresioneze — a fost făcută să învețe din ea. Iar critica onestă face parte din asta.
 De